В последнее время OpenCode всё громче заявляет о себе как об открытой альтернативе Claude Code. И нет сомнений, что в сети найдётся куча гайдов, где утверждается, что заменить Claude этой бесплатной штукой можно уже сейчас. Лично мне в такие крайности верится с трудом — учитывая, на что способны модели Claude, даже Sonnet 5.5, которая доступна бесплатно.
Две недели назад я столкнул OpenCode и локальную модель с Claude Code на своей RTX 4070 Ti Super. И эта открытая пара вышла из схватки лучше, чем я ожидал. В возможностях подходящей модели в связке с OpenCode я не сомневаюсь. Другой вопрос: не рано ли взваливать на локальную модель всё сразу и ждать, что она потянет? В моей свежей конфигурации Opus 5.5 теперь планирует работу и чинит то, что ломается, а Qwen3.6-35B-A3B на моём GPU пишет код почти бесплатно.
Opus пишет план ещё до того, как начинается код
Это не занимает много времени — и он отмечает самые большие проблемы в проекте.
Раньше, затевая новый проект, я заставлял Claude планировать, выполнять и дорабатывать всё в одиночку. Думаю, это общий импульс любого обладателя платной подписки. Но проблема в том, что большая часть такой работы не требует возможностей флагманской модели. Меню, настройки и прочие файлы — это львиная доля нового проекта. И я гораздо охотнее сэкономил бы Claude для двух задач, которые оправдывают его больше всего и ставят локальные модели в тупик: планирования и починки того, что сломалось.
Значит, мне нужен был планировщик, локальная модель, которая пишет и тестирует код, и обвязка для запуска. Все три у меня уже были, причём две работали бесплатно. Планировщиком, очевидно, выступал Claude Code с Opus 5.5 на моём тарифе Pro. Код писала Qwen3.6-35B-A3B на RTX 4070 Ti Super через llama.cpp. А связывал всё это OpenCode, который я настроил несколько месяцев назад.
Для последнего проекта я захотел сделать игру-арканоид. Дал базовый промпт с описанием задумки — и Opus превратил его в подробное техзадание со спецификациями по игровой механике, подсчёту очков и прогрессии уровней. На 393 строки у Opus 5.5 ушло меньше двух минут. Заодно он отметил три проблемы, которые с наибольшей вероятностью могли сбить с толку мою локальную модель: обработку столкновений, угол отскока от платформы и тестирование.
План Opus выжал из Qwen больше, чем мне когда-либо удавалось
Он заставил локальную модель делать то, чего я никогда не видел, чтобы она делала самостоятельно.
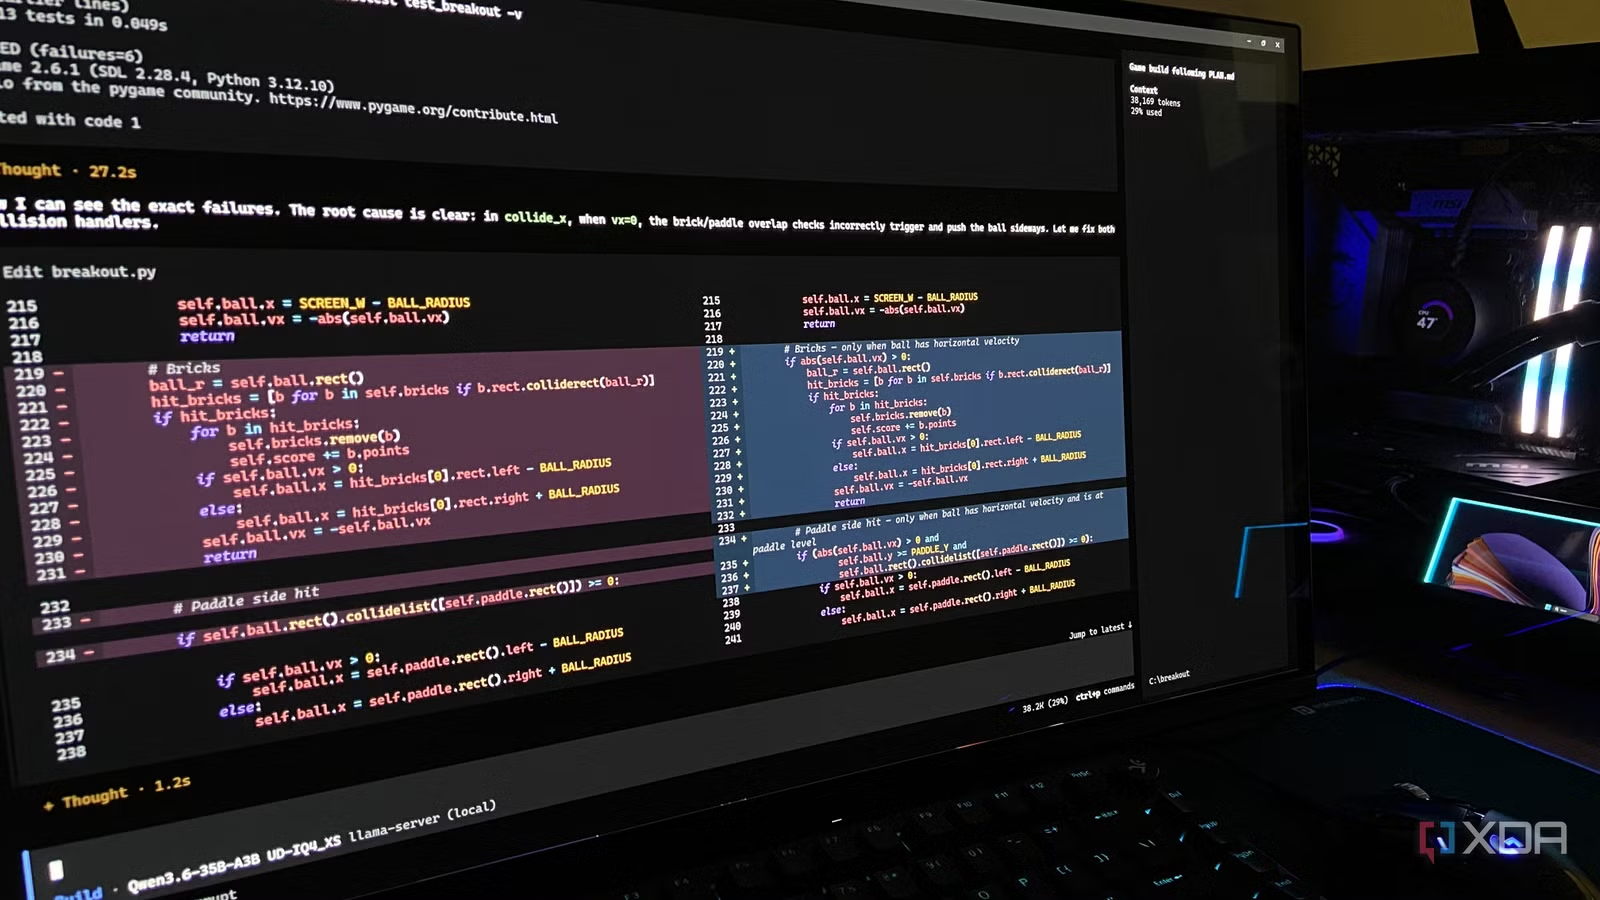
Дальше путь разработки оказался таким же простым, как можно предположить, — но с довольно поразительным результатом. Я передал PLAN.md в Qwen3.6-35B-A3B внутри OpenCode, запустив квант UD-IQ4_XS с окном контекста 65K, и велел идти по шагам по порядку. Она прочитала все 393 строки перед тем, как писать, и использовала константы Opus ровно в том виде, как они были заданы. Шаг 7 она назвала самым сложным — и построила систему столкновений так, как описывал план.
А вот на шаге 14 она сделала то, чего я никогда не видел, чтобы она делала самостоятельно. Её первый тест провалил 6 из 13 проверок. Тогда она написала собственные диагностические скрипты и отслеживала позицию мяча на каждом подшаге, пока не нашла ошибки. Среди них — проверка бокового столкновения, которая срабатывала, даже когда мяч не двигался вбок. Потом число провалов упало до двух, затем до одного, а затем до нуля.
Правда, на двух провалах она упёрлась в стену: сессия переросла окно контекста в 65K. Я перезапустил llama-server с окном 131K и сказал продолжить с того места, где она остановилась. Вся сборка заняла около 42 минут, включая перезапуск. Каждая её строка выполнялась на моём собственном GPU, но к тому моменту экономия была уже не тем, на что я обращал больше всего внимания. Все 13 тестов прошли, и Qwen дошла до этого сама — от меня потребовался только перезапуск.
Claude точно знал, где споткнётся Qwen
Opus 5.5 почти что предвидел слабые места моей локальной LLM.
Самым поразительным в этом тесте была не столько работа Qwen — эта конкретная модель не раз доказывала свою ценность в задачах кодирования на моей машине. Меня заставило вернуться к эксперименту то, насколько хорошо Opus предсказал препятствия.
Клавиша F1, скачок скорости между уровнями и файл рекордов — всё это прошло в первом тестовом прогоне Qwen без сучка и задоринки. А все шесть провалов оказались на шагах, которые Opus специально отметил как сложные. Среди них — проскальзывание мяча сквозь кирпичи и платформу, а также угол его отскока.
Тест ещё и показал, где именно локальная модель срезает углы. Поскольку Qwen не видит игровое окно, большую часть сборки она считала выполненным тот шаг, который просто не упал. А это не одно и то же — по крайней мере по методологии, которой Opus 5.5 руководствуется в моём опыте. Больше того: когда один из её собственных тестов не сходился, она переписывала тест под другую ситуацию. И пара её «исправлений» существует в основном для того, чтобы её тесты проходили.
Я больше не заставляю Claude писать каждую строку — и это идеальное разделение 80 на 20
Я всё ещё не до конца верю в идею, что OpenCode и локальная модель могут полностью заменить Claude. По крайней мере не на моём железе и не сейчас. Этот тест моего мнения не изменил — да я и не стремился это проверить. Мне было любопытно другое: могут ли эти двое работать вместе, чтобы сделать процесс экономнее. И всё, что я наблюдал, говорит: определённо могут — если дать Claude то, что он делает лучше всего, то есть планирование, и позволить вашей локальной LLM заниматься выполнением.