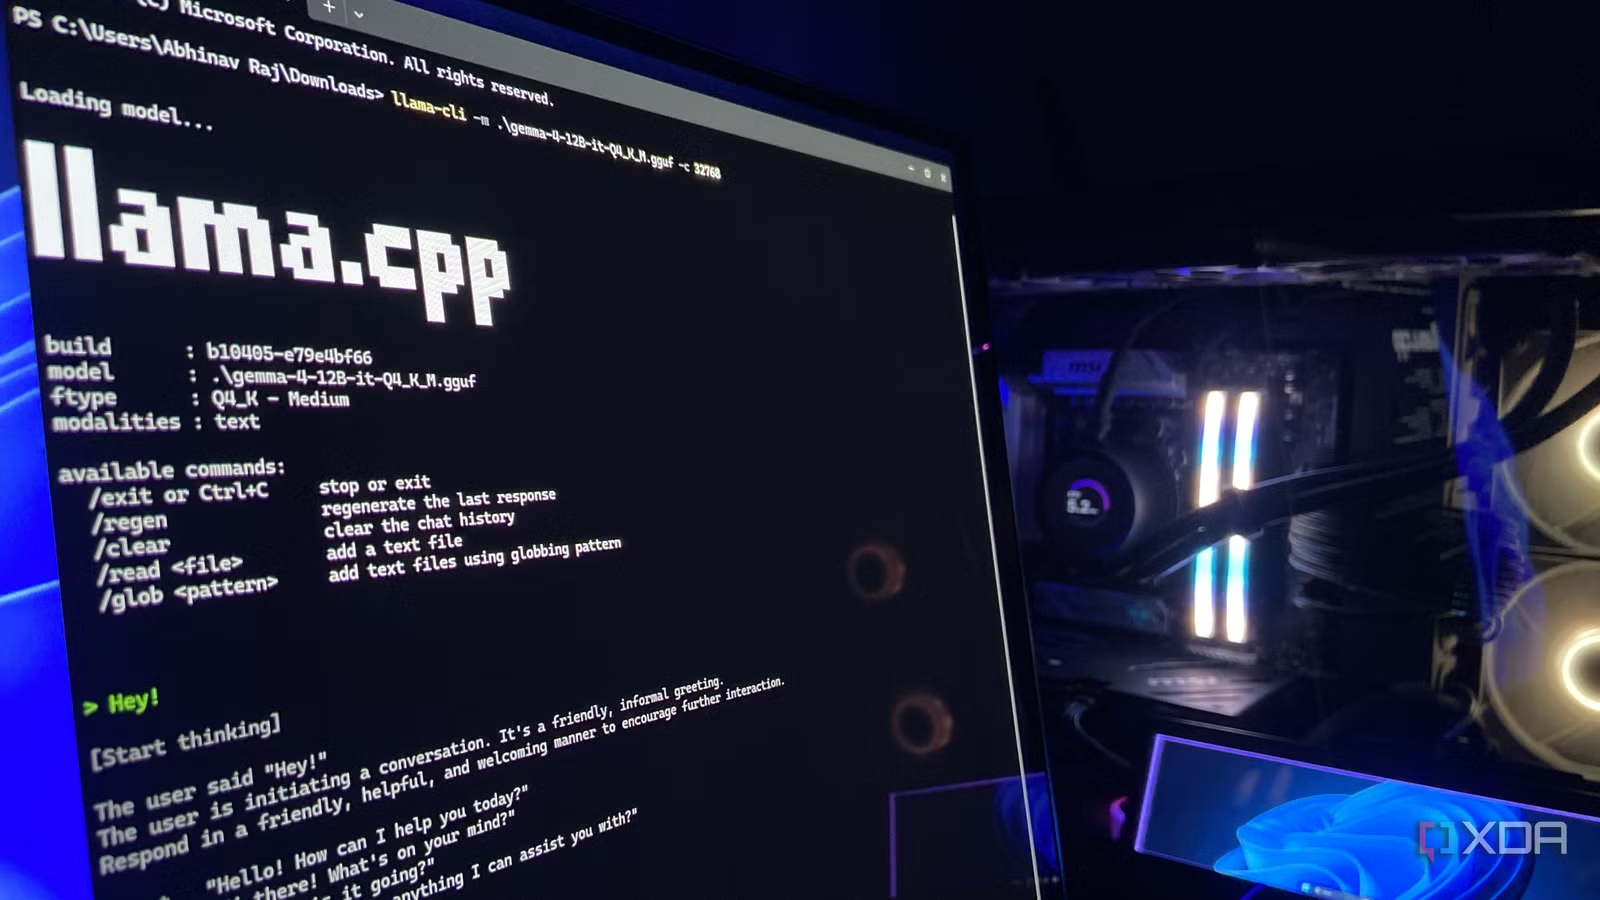
Когда я начал запускать локальные ИИ-модели, Ollama стала моим способом по умолчанию. Долгое время она не давала ни малейшего повода жаловаться — и, готов поспорить, для большинства новичков всё было так же. Я отдаю себе отчёт: у локального инференса есть острая проблема трения. Чистый GUI вроде олламовского не заставляет копаться в настройках и потому с меньшей вероятностью отправит вас обратно к облачным альтернативам.
Так почему же средний пользователь вроде меня вообще стал бы переходить на llama.cpp? Большинство решило бы, что причиной ухода станет скорость инференса. Но с мая Ollama запускает модели через llama.cpp, и для тех моделей, что гоняю я, разрыв исчез. Только в локальном ИИ удобство — само по себе важный аргумент. Вот почему я всё равно перешёл.
Модель больше видеопамяти — и всё равно быстрее всех
Qwen3.6-35B-A3B весит 17,7 ГБ — по всем меркам слишком много, чтобы аккуратно уместиться в 16 ГБ GDDR6X на моей RTX 4070 Ti Super. И всё же именно она быстрее всех остальных моделей, которые я запускаю на обоих движках. Всё дело в архитектуре mixture-of-experts: из 35 миллиардов параметров на каждый токен работает лишь около 3 миллиардов. Значит, часть экспертных слоёв можно выгрузить в системную RAM без потери скорости генерации — главное, чтобы то, что выполняется на каждом токене, оставалось в памяти GPU.
На настройках по умолчанию оба рантайма неплохо её разместили, но Ollama чуть вырвалась вперёд: 77,02 токена в секунду против 74,75 у llama.cpp при контексте 32K. Зато у последнего есть аккуратный трюк — флаг --n-cpu-moe, который задаёт, сколько слоёв держат своих экспертов в системной RAM. Ещё я ограничил сервер одним чат-слотом вместо четырёх по умолчанию: весь бюджет контекста достаётся одному слоту, а освободившаяся память уходит на размещение большей части модели на GPU.
С экспертами восьми слоёв в RAM та же модель на той же видеокарте выдала 81,43 токена в секунду. У Ollama эквивалента этому нет. Впрочем, запрос на такую функцию открыт с августа 2025 года.
Qwen3.6-35B-A3B, контекст 32K:
- Ollama (по умолчанию) — 77,02 токена в секунду
- llama.cpp (по умолчанию) — 74,75 токена в секунду
- llama.cpp (с флагом --n-cpu-moe 8) — 81,43 токена в секунду
llama-bench избавляет от ложных выводов
Одна из ключевых задач при настройке локального ИИ-стека — понять, какие параметры лучше всего работают именно на вашем железе. Конфигурации у всех разные, поэтому настройки из интернета, обещающие «максимум токенов в секунду» и наивысшее качество генерации, вам могут не подойти так же хорошо, как автору обзора. Надёжный способ узнать — измерить самому.
Проблема, с которой я сталкивался чаще всего, — прогрев кэша. В одном тесте с Gemma 4 12B Ollama выдала 44,98 токена в секунду, и я почти занёс это в лог. А в следующем прогоне с тем же промптом скорость поднялась до 61,76 токена в секунду.
Разброс в 37% при одинаковых настройках — и всё из-за того, что первый прогон ещё грузил веса в VRAM. Средний пользователь с моделью покрупнее решил бы, что она работает ужасно, и на основании этого ошибочного вывода отправил бы файл прямым ходом в корзину. У llama.cpp есть встроенное решение — llama-bench. Он измеряет обработку промпта и генерацию отдельно, прогоняет каждый тест пять раз и сообщает среднее значение.
Модели лежат там, где мне удобно
Отличная черта llama.cpp — движку всё равно, где на диске лежит модель. Я указываю llama-server на GGUF, который может быть где угодно на моём ПК, и до интерфейса чата — столько же кликов. Ollama же требует Modelfile и шага ollama create, который копирует всю модель в собственную папку.
Многим это покажется мелкой придиркой. Но когда вы часто перекладываете модели и качаете несколько сразу, накапливаются десятки гигабайт дубликатов, которые потом приходится чистить вручную. Для контекста: примерно на трёх моделях у меня вышло около 41 ГБ лишних файлов.
Сам процесс импорта тоже путает новичков. Я лично наткнулся на ошибки «invalid model name» и «unexpected EOF» — старый Modelfile подхватил файлы, которых я не просил. Ничего неподъёмного, но каждый обходной путь — это лишний шаг, которого другая открытая альтернатива не требует.
Есть и мелочи. Чтобы поменять top_k или top_p в Ollama, придётся править Modelfile, лезть в CLI или дёргать API — зависит от того, как вы запускаете модель. В WebUI у llama.cpp это делается в один клик в меню настроек. Крайне удобно, если вы крутите эти значения по десятку раз в день.
Рантайм получше Ollama существует давно
Я прекрасно понимаю привлекательность Ollama. Это по сути опыт «скачай и общайся» — именно его ищут новички и те, кто хочет сэкономить на облачных подписках. Для них она отлична. Скажу больше: она сделала локальный ИИ доступным для тех, кто иначе никогда бы не ступил на эту территорию. Но как только эти же люди освоятся с llama.cpp и начнут возиться с моделями на Hugging Face, готов поставить небольшое состояние — возвращаться они не захотят.
llama.cpp — открытый фреймворк, который запускает большие языковые модели локально на вашем компьютере.