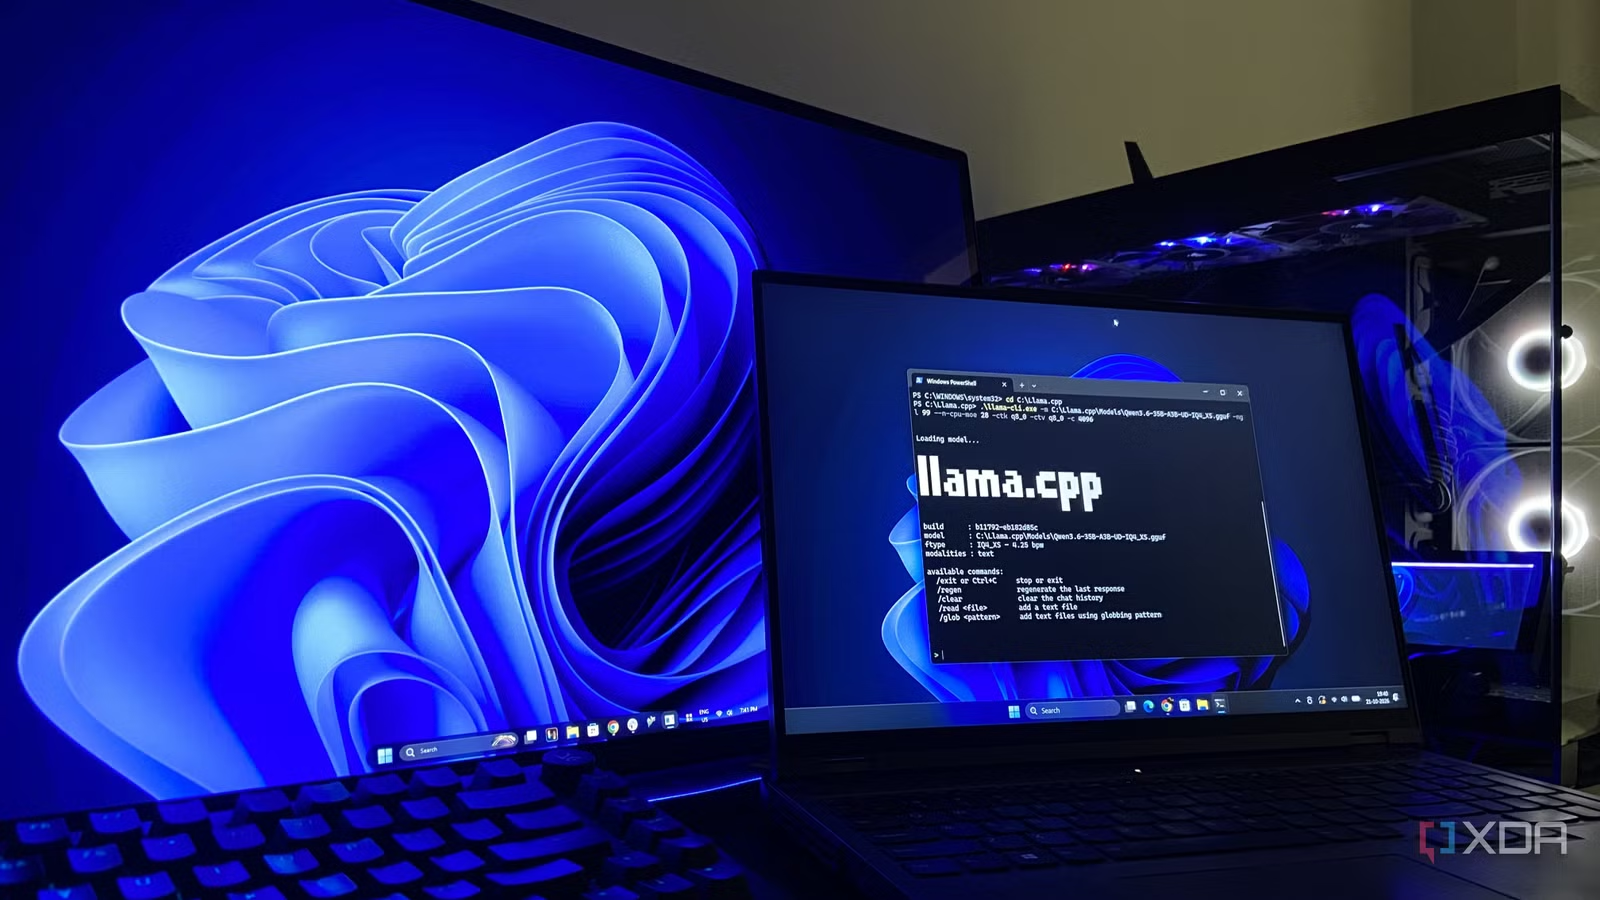
Многое из того, что вы делаете на своём ПК, упирается в объём VRAM на видеокарте. От него зависит, в каком разрешении идут игры, какой по размеру видеопроект вы отредактируете без того, чтобы таймлайн дёргался, и — самое свежее — какие локальные модели ИИ у вас вообще запустятся. Почти все эти ограничения кажутся железобетонными, но почти для каждого есть обходной путь.
Проще всего обходные пути даются в локальном выводе ИИ. Я уже мысленно списал свой Lenovo Legion 5 с 8 ГБ на RTX 3070 Mobile: мол, какие там модели, когда на десктопе стоит RTX 4070 Ti Super с 16 ГБ GDDR6X. Но за пару недель тестов нашёлся приём, который позволяет ноутбуку самому тянуть крупные модели на приемлемой скорости.
Флаг, из-за которого всё завертелось
На прошлой неделе я рассказывал, как переносил свой локальный ИИ-стек с Ollama на llama.cpp. Пока гонял среду выполнения и её возможности, меня осенило: одна из функций наверняка поможет выжать больше из слабой системы с маленьким бюджетом VRAM — той, на которой такие модели работать в принципе не должны. На десктопе с RTX 4070 Ti Super быстрее всего шла Qwen3.6-35B-A3B при квантовании IQ4_XS и контексте 32K — при том что это файл на 17,7 ГБ, лежащий поверх 16 ГБ GDDR6X.
Математика, конечно, говорит, что модель в VRAM не влезет. Но модели Mixture-of-Experts (MoE, смесь экспертов) давно переписали эту математику. Из 35 млрд параметров при выводе активируется примерно 3 млрд, остальные простаивают. Значительная часть трюка — держать спящие экспертные слои в системной RAM, пока постоянно активные части сети спокойно живут на GPU.
Флаг, который это включает, — --n-cpu-moe N. Вместе с -ngl 99 он говорит llama.cpp загрузить каждый слой на GPU, а --n-cpu-moe затем снимает экспертные тензоры первых N слоёв обратно и держит их в системной памяти. В итоге слои внимания, эмбеддинги, общие веса и — что важнее всего — KV-кэш остаются в VRAM, а именно от них зависит скорость генерации токенов. Экспертные слои лежат в системной памяти и подгружаются только тогда, когда их выберет роутер.
Неудивительно, что я задумался про ноутбук. Если модель на 17,7 ГБ живёт на системе с 16 ГБ VRAM, то насколько этот же трюк растянет систему с 8 ГБ? Ради этого вопроса и затевался эксперимент.
Одна команда, чтобы всё проверить
До всяких флагов мне нужен был честный и воспроизводимый ответ: тянет ли 8 ГБ на ноутбучной RTX 3070 что-то крупнее, чем модели, под которые её проектировали? Лучшего способа проверить это, чем утилита llama-bench из состава llama.cpp, я не знаю.
В тесте участвовали обе модели, что лежат на ноутбуке: Qwen3.6-27B в квантовании IQ4_XS и Qwen3.6-35B-A3B в квантовании UD-IQ4_XS. Зачем плотная модель, у которой экспертные слои в RAM не выгрузишь? Затем, что она — эталон для сравнения. Запускал я вот так:
.\llama-bench.exe -m Qwen3.6-27B-IQ4_XS.gguf -m Qwen3.6-35B-A3B-UD-IQ4_XS.gguf -ngl 99 -ncmoe 0,28 -p 512 -n 128 -r 3 -ctk q8_0 -ctv q8_0
Команда прогоняет четыре конфигурации на обеих моделях: каждую при --n-cpu-moe 0 (без выгрузки) и при 28 (веса экспертов 28 слоёв уезжают в системную RAM). Давайте разберём, что значит каждый флаг.
-ngl 99 велит llama.cpp попытаться загрузить каждый слой на GPU. -p 512 -n 128 задают предзаполнение (prefill) на 512 токенов с последующей генерацией 128 токенов за прогон: это значения по умолчанию для llama-bench, и их хватает, чтобы числа устоялись. -r 3 повторяет каждую конфигурацию трижды, чтобы отдельные удачные прогоны не размазывали картину. Наконец, -ctk q8_0 -ctv q8_0 квантуют KV-кэш до 8 бит.
Вот что выдал llama-bench после прогона:
| Модель | Слои MoE в RAM | Обработка промпта (токенов/с) | Скорость генерации (токенов/с) |
|---|---|---|---|
| Qwen3.6-27B (Dense, IQ4_XS, 14,37 ГиБ) | не применимо (плотная модель) | 38,83 | 0,75 |
| Qwen3.6-35B-A3B (MoE, UD-IQ4_XS, 16,50 ГиБ) | 0 | 109,66 | 4,02 |
| Qwen3.6-35B-A3B (MoE, UD-IQ4_XS, 16,50 ГиБ) | 28 | 341,37 | 32,82 |
4 токена в секунду превратились в 33
Долго моя мысленная модель локального ИИ была простой и обманчивой — как, подозреваю, у большинства. Серьёзные модели гоняет десктоп, а ноутбуку хватит того, что влезет в VRAM из небольших вариантов Gemma 4. Эксперимент опроверг это ожидание — пожалуй, самым приятным из возможных способов.
Да, 35B MoE-модель, которая еле выдавала 4 токена в секунду, на том же самом железе разогналась до 33 токенов в секунду — только за счёт флагов. 33 токена в секунду заметно быстрее, чем я читаю, а значит, с моделью уже комфортно работать.
Лучшие модели больше не привязаны к настольному ПК. И главное, что эта оптимизация меняет для меня — и, держу пари, для большинства таких же пользователей, — это уровень доступа. Кажется, будто 35B MoE можно запускать только дома, за столом рядом с рабочей станцией. Но с правильными флагами и настройками ту же модель можно носить с собой: в самолёте, в отеле, где угодно без сети. Вот это llama.cpp и даёт.
Для тех, кто не в курсе: llama.cpp — фреймворк с открытым исходным кодом, который запускает большие языковые модели локально на вашем компьютере.