Старое железо — отличная база для self-hosting. Большинство FOSS-приложений прекрасно живут в лёгких контейнерах, так что превратить пылящийся ноутбук в домашний сервер несложно. С локальными LLM (large language models, большие языковые модели) всё иначе: тут нужна выделенная видеокарта, а значит — хоть какая-то вычислительная мощность.
Хорошая новость: даже GPU десятилетней давности справляются с self-hosting LLM, если дать им правильные инструменты. Моя GTX 1080 эпохи Pascal первой показала, что это реально, — с тех пор я запускал модели и на других картах из своего арсенала. А недавно попробовал поднять инференс исключительно на GTX 1060 из старого Acer Predator Helios 300. Результат впечатлил настолько, что я решил сделать из ноутбука локальную ИИ-станцию для всего дома.
LXC-контейнер llama.cpp гоняет инференс на GPU старого ноутбука. Настроить всё это на Proxmox оказалось на удивление просто.
Почему Proxmox, а не голый Debian
Debian отлично подошёл бы для этого проекта, но мне хотелось чего-то удобнее, чем настройка через SSH и CLI. Я планировал развернуть на одной машине пару FOSS-сервисов с ИИ-нагрузкой, и гонять всё терминальными командами быстро надоедает. Поэтому выбор пал на короля легковесных дистрибутивов для домашнего сервера — Proxmox.
Установка PVE прошла как по маслу, хотя пришлось повозиться с драйверами для снятой с производства видеокарты. К счастью, ранее в этом году Nvidia выпустила набор драйверов, исправляющий ошибку DKMS при установке на карты Pascal. Этот пакет хорошо работал на моей машине Proxmox с GTX 1080, так что я взял его и для устаревшего Predator Helios 300.
nvidia-smi показал GPU во всей красе — пора было настраивать движок инференса. Можно было взять контейнер Ollama из сверхполезного репозитория PVE Community Scripts, но для специализированных ИИ-задач он медлительный. Поэтому я переключился на llama.cpp — точнее, на его Vulkan-версию в виде LXC. У неё самый безболезненный процесс настройки из всех бэкендов и стабильная производительность в задачах инференса с поддержкой GPU.
Проброс GPU тоже оказался простым: достаточно передать идентификаторы устройств GTX 1060 в конфигурационный файл LXC. Помимо обычного набора пакетов из официальной документации Vulkan на странице llama.cpp в GitHub, пришлось поставить libvulkan-dev, spirv-tools и spirv-headers. После нескольких проб и ошибок я понял, что в /usr/share/vulkan/icd.d/nvidia_icd.json нужно добавить такой фрагмент:
{
«file_format_version»: «1.0.0»,
«ICD»: {
«library_path»: «libGLX_nvidia.so.0»,
«api_version»: «1.3»
}
}
С этими обходными путями настройка llama.cpp свелась к получению пакета и запуску cmake -B build -DGGML_VULKAN=ON для сборки Vulkan-бэкенда, а затем cmake --build --config Release -j$(nproc) — и движок готов к бою.
Gemma 4 E4B на 6 ГБ VRAM
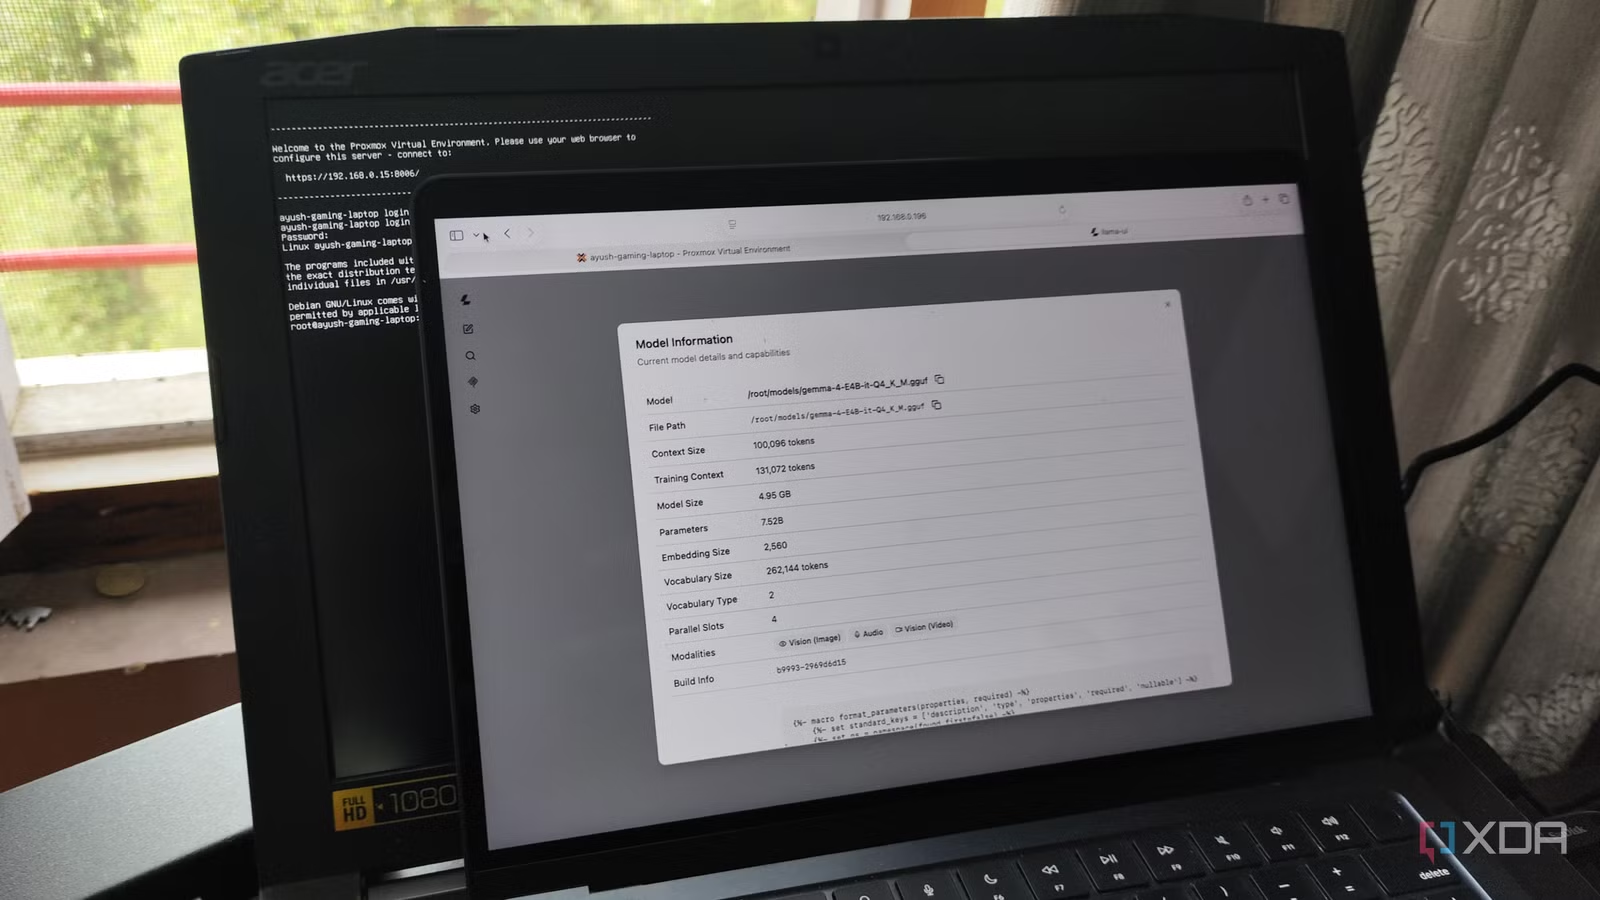
У GTX 1060 всего 6 ГБ VRAM, так что модель нужна легковесная. Было искушение поэкспериментировать с громоздкими MoE-моделями, но при единственной планке памяти на 16 ГБ LPDDR4 в ноутбуке я выбрал старую добрую Gemma 4 E4B (Q4_K_M).
Хотя общее число параметров у неё в диапазоне 8B, во время инференса лёгкая LLM задействует только 4,5B параметров — это хорошо помещается в скромную VRAM старой карты. Благодаря Per-Layer Embeddings и мультимодальным возможностям Gemma 4 E4B достаточно умна, чтобы тянуть простые задачи инференса для моих FOSS-инструментов.
По скорости сервер llama.cpp на базе GTX 1060 выдаёт больше 30 токенов в секунду с Vulkan-бэкендом. Для ноутбука девятилетней давности это чертовски впечатляюще. А поскольку инференс идёт в VRAM видеокарты, системной памяти остаётся много свободы. Я развернул на ноутбуке пару self-hosted сервисов в виде LXC и направил их ИИ-функции на IP-адрес своего llama-server.
Blinko, например, использует Gemma 4 E4B для автоматической расстановки тегов в заметках, а Karakeep — для коротких резюме сохранённых закладок, документов и видео с YouTube. Есть ещё Paperless GPT: он применяет способности Gemma 4 E4B к рассуждению, чтобы генерировать точные OCR-сканы перед отправкой в Paperless-ngx на моём NAS.
Две меры предосторожности
Пришлось отдельно разобраться с батареей и крышкой ноутбука.
Несмотря на то что ноутбук служит отличным узлом Proxmox, у него есть оговорки. Встроенная батарея — палка о двух концах. Она позволяет работать даже при отключении электричества, но если держать ноутбук подключённым к сети 24/7, она неизбежно вздуется и станет потенциальной пожарной опасностью.
Сейчас у меня импровизированное решение на конвейере автоматизации Home Assistant. Сначала он принимает статистику батареи от Proxmox (точнее, от сервера Glances на нём) как условие-триггер. В зависимости от текущего уровня заряда он включает или выключает умную розетку, подключённую к зарядному устройству ноутбука. Так тот не остаётся под напряжением при 100% весь день.
Ещё советуют закрывать крышку, чтобы уменьшить вертикальный габарит ноутбука-сервера. В моей конфигурации я бы так никогда не сделал: если крышка закрыта, пока ноутбук гоняет LLM, нарушается воздушный поток, и всё тепло от инференса бьёт по клавиатуре и экрану.
Что в итоге
Старый игровой компаньон уже не тянет современные игры без снижения графики на ступень, но локальной рабочей станцией для простых ИИ-задач оказался на удивление эффективным. Полагаться на него в запуске MoE-моделей для кодинга и реверс-инжиниринга я бы не стал: GTX 1060 под крышкой не выдаст ту же мощь, что RTX 3080 Ti. А вот с автоматической расстановкой тегов, OCR и суммаризацией старый Helios 300 всё ещё тянет свою ношу.
llama.cpp — открытый фреймворк, который запускает большие языковые модели локально на вашем компьютере.